

escrito por Kristy Noms
10 minutos de leitura
O Databricks Lakebase não tem literalmente um Git, mas traz um conceito bastante semelhante: o branching de banco de dados.
Assim como no desenvolvimento de software é possível criar uma branch para trabalhar de forma isolada sem alterar diretamente o código principal, no Lakebase é possível criar branches de uma instância de banco de dados para desenvolvimento, testes, investigação de problemas e até recuperação de dados.
Na prática, esse recurso pode ajudar a acelerar entregas, reduzir o custo de ambientes de desenvolvimento e QA e manter ambientes mais próximos da realidade de produção.
Mas como isso funciona?
Em ambientes OLTP (Online Transaction Processing) com grande volume de dados, alguns desafios são recorrentes:
Atualização dos ambientes de desenvolvimento e QA: dependendo do método utilizado para realizar um dump do banco, a atualização pode levar horas ou até dias.
Fidelidade em relação à produção: para testar um deploy ou medir o impacto de uma alteração, é importante contar com um ambiente que represente de forma fiel os dados de produção.
Investigação de problemas: em alguns casos, é necessário reproduzir um cenário ou investigar um comportamento sem interferir diretamente no ambiente produtivo.
Recuperação de dados: situações como um UPDATE executado sem WHERE ou uma exclusão incorreta podem exigir a recuperação de informações existentes antes do incidente.
É nesse contexto que o branching do Lakebase pode fazer diferença.
O Databricks Lakebase é um banco de dados PostgreSQL totalmente gerenciado pela Databricks e baseado em uma arquitetura serverless.
Um dos principais diferenciais está na separação entre compute e storage, permitindo escalar o banco de dados sem precisar lidar diretamente com o dimensionamento do armazenamento.
O Lakebase utiliza armazenamento em object storage, permitindo trabalhar com grandes volumes de dados sem que a preocupação com espaço em disco seja o principal limitador da arquitetura.
Para entender o funcionamento do branching, é importante conhecer alguns elementos da arquitetura do Lakebase.
Em um PostgreSQL tradicional, os dados são armazenados em datafiles e os registros do WAL são organizados em arquivos de 16 MB. No Lakebase, a arquitetura funciona de uma maneira diferente.
Os arquivos de camada, chamados de layer files, armazenam páginas de 8 KB. Essas páginas são trabalhadas pelo Pageserver, enquanto o Safekeeper recebe os registros de WAL do banco de dados e garante sua persistência.
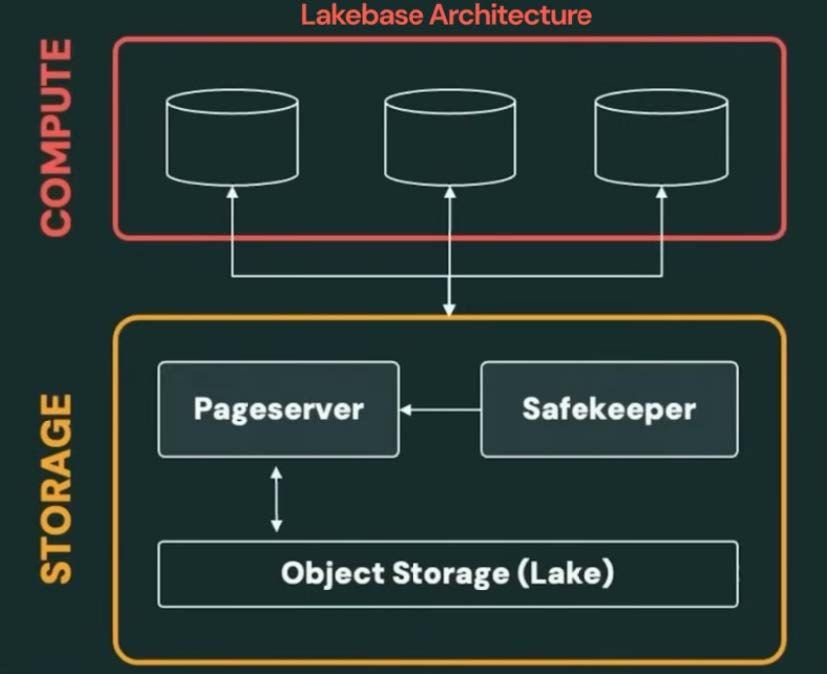
O Pageserver aplica os registros de WAL aos layer files e mantém as informações necessárias para a operação do banco.
Quando uma página não está disponível no shared buffer, ela pode ser carregada para a memória. Depois que deixa de ser utilizada, pode ser armazenada no object storage e recuperada novamente quando necessário.
Isso também muda a forma como o checkpoint funciona.
Em um PostgreSQL tradicional, o checkpoint persiste no disco as páginas alteradas que estão no buffer. No Lakebase, quando o shared buffer fica cheio, páginas alteradas podem ser liberadas sem a necessidade de realizar esse flush, porque os registros de WAL mantidos pelo Safekeeper garantem a integridade das informações.
É aqui que o conceito fica mais interessante.
Quando uma nova branch é solicitada, o Lakebase identifica o LSN (Log Sequence Number) correspondente ao momento da criação e cria um ponteiro no Pageserver para que a nova branch utilize os dados daquele ponto.
Na prática, a cópia fica disponível em segundos.
Isso acontece porque os dados não precisam ser duplicados fisicamente para criar uma nova branch.
A branch utiliza a estrutura de dados existente e passa a registrar separadamente apenas as alterações realizadas a partir daquele momento. Por isso, a criação de um novo ambiente pode ser muito mais rápida do que realizar uma cópia completa do banco.
Outro ponto importante é que a criação da branch não altera os dados de produção.
Além disso, o compute é separado da branch raiz, evitando que a utilização do novo ambiente afete diretamente o ambiente produtivo.
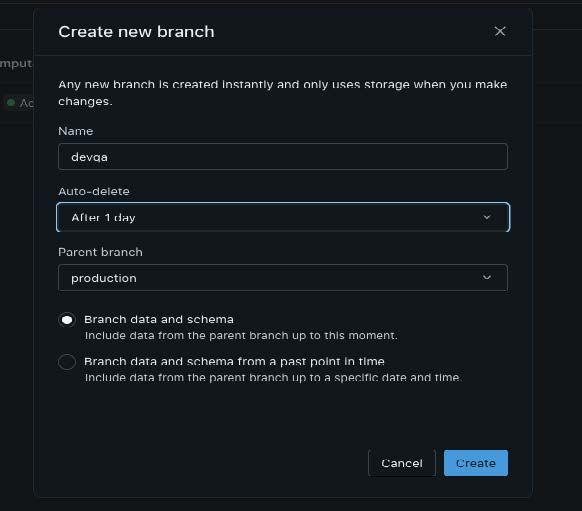
Ao criar uma branch, é possível definir:
nome da branch;
tempo de vida (TTL);
branch pai;
ponto inicial dos dados, podendo ser o estado atual ou um ponto anterior disponível para restauração.
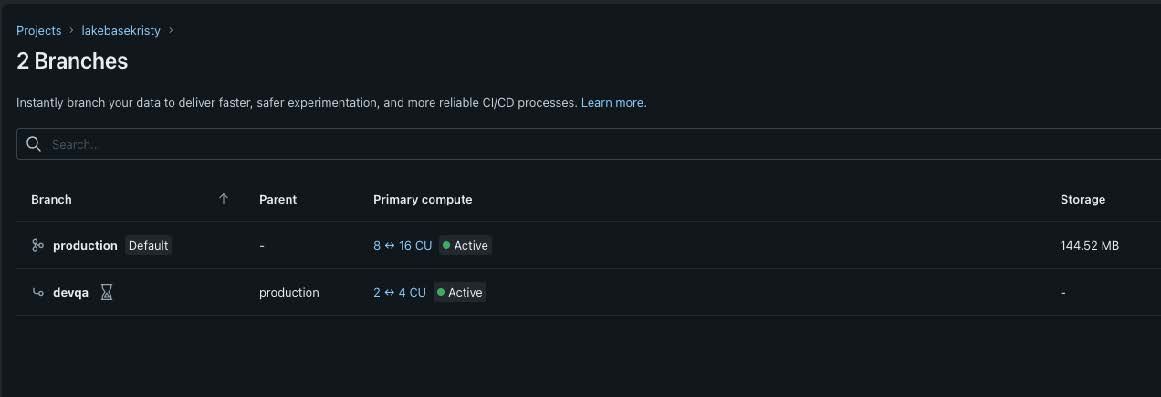
Depois da criação, a hierarquia entre as branches pode ser visualizada no ambiente do Lakebase.
Um ponto interessante é que a nova branch não ocupa imediatamente um espaço equivalente ao banco original. O armazenamento adicional passa a ser utilizado conforme novas alterações são realizadas na branch.
Ou seja, o custo de storage está relacionado às mudanças feitas a partir daquele ponto.
Outra possibilidade é comparar o schema de diferentes branches diretamente pelo console da Databricks.
Por exemplo, podemos criar uma tabela em uma branch de desenvolvimento e, posteriormente, verificar a diferença entre ela e a branch de origem.
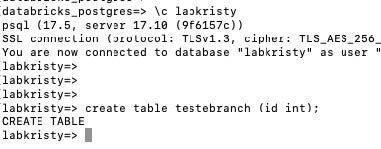
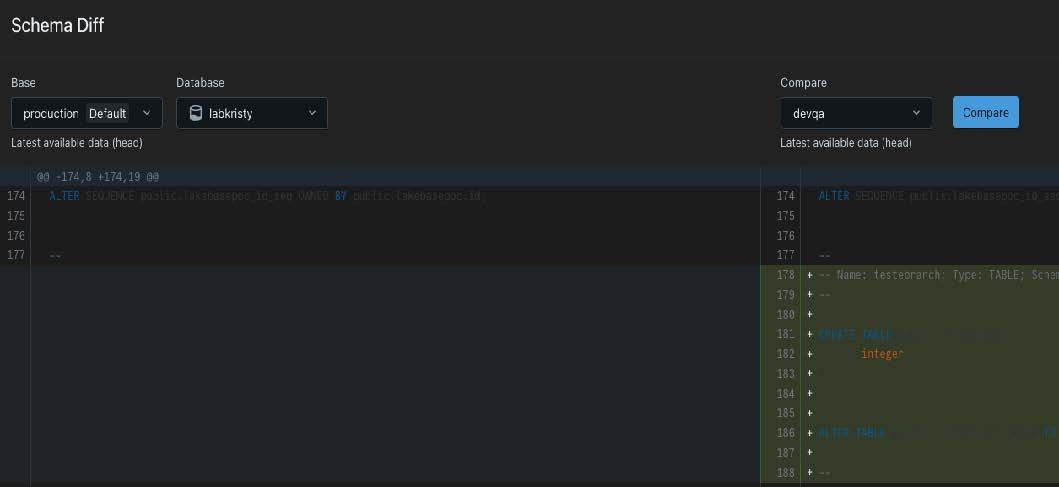
Essa comparação facilita a identificação das alterações realizadas durante o desenvolvimento antes que elas sejam utilizadas em outros ambientes.
O branching também permite organizar ambientes de desenvolvimento de maneira mais granular.
A partir de uma branch, é possível criar novas branches para diferentes desenvolvedores, cada uma com seu próprio endpoint.
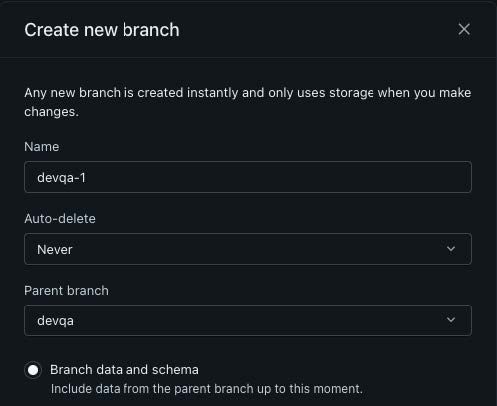
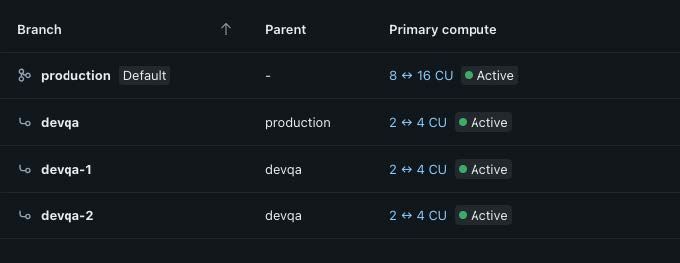
Dessa forma, cada pessoa pode trabalhar de forma isolada, realizando alterações e testes sem interferir diretamente no ambiente utilizado pelos demais desenvolvedores.
Esse modelo pode ser especialmente útil em equipes que precisam trabalhar simultaneamente em diferentes funcionalidades ou investigar problemas específicos.
Um ponto importante do database branching é entender que as branches funcionam como snapshots do momento em que foram criadas.
Isso significa que alterações realizadas posteriormente na branch principal não são automaticamente replicadas para as outras branches.
Imagine, por exemplo, que uma branch de desenvolvimento tenha sido criada hoje. Amanhã, novos dados são inseridos na branch principal. A branch de desenvolvimento não receberá automaticamente essas novas informações.
Para atualizar a base utilizada pela branch, é possível recriá-la a partir de um ponto mais recente ou utilizar a opção de reset from parent.
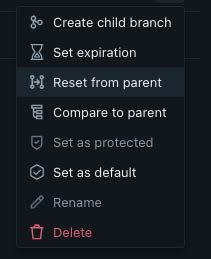
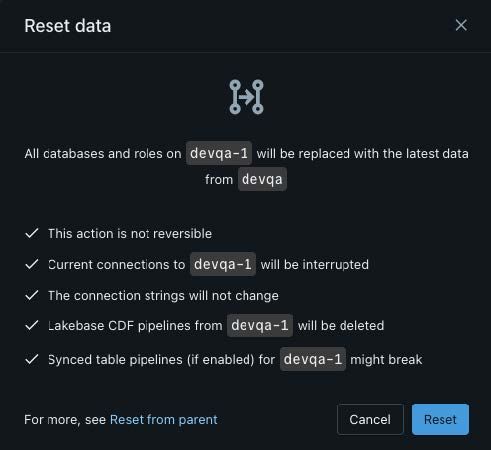
No entanto, é importante ter atenção: tudo o que tiver sido realizado na branch antes do reset será perdido durante essa atualização.
Além do desenvolvimento e dos testes, o branching pode ser utilizado em situações de recuperação de dados.
Imagine que um problema tenha ocorrido na branch principal e que seja necessário recuperar os dados existentes duas horas antes do incidente.
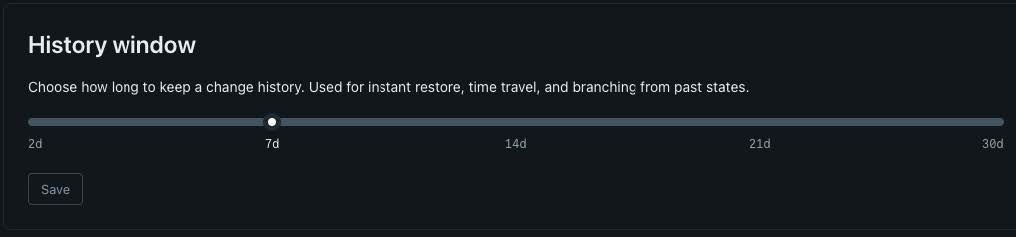
Nesse cenário, é possível voltar a um ponto anterior dentro da janela de restauração configurada.
Dependendo da configuração da janela de restauração, é possível recuperar dados de pontos anteriores, chegando a até 30 dias.
O processo de recuperação não é realizado diretamente na branch principal. Em vez disso, é criada uma nova branch contendo os dados daquele ponto específico.
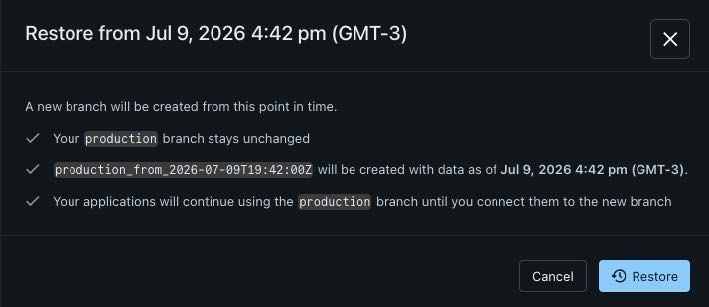
Isso permite investigar ou recuperar informações sem alterar novamente o ambiente principal.
Para utilizar os dados recuperados, porém, é necessário alterar as informações de conexão para apontar para a nova instância.
Atualmente, não é possível simplesmente renomear essa nova instância para substituir a original.
E se alguém remover acidentalmente a branch principal? O que aconteceria com o ambiente de produção?
Para evitar esse tipo de situação, o Lakebase permite habilitar uma proteção para a branch.
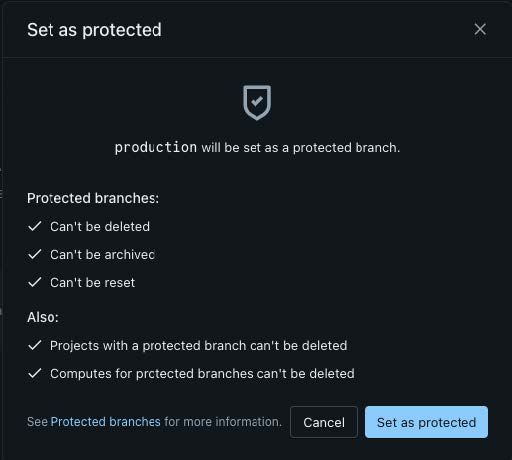
A proteção ajuda a evitar alterações ou exclusões acidentais na branch principal e deve fazer parte das configurações de segurança do ambiente.
Apesar das facilidades proporcionadas pelo branching, alguns cuidados são importantes antes de disponibilizar uma nova branch para desenvolvimento ou testes.
Ao criar um clone do banco de dados, os usuários também são clonados.
Por isso, é importante revisar as permissões antes de disponibilizar o novo ambiente e ajustar os acessos conforme a necessidade de cada equipe ou pessoa.
O storage é apenas uma parte do custo de um ambiente.
Também é necessário avaliar os recursos de compute utilizados pelas branches e suas configurações de autoscaling, evitando custos inesperados.
A proteção da branch principal é uma configuração importante para reduzir o risco de alterações ou exclusões acidentais.
Se uma branch será utilizada somente durante um período específico, vale configurar um TTL (Time to Live).
Assim, branches temporárias podem ser encerradas automaticamente depois do período definido, evitando a manutenção desnecessária de recursos e custos.
O branching do Lakebase traz para o banco de dados uma lógica que já é bastante familiar para quem trabalha com desenvolvimento de software.
Em vez de criar cópias completas do banco para cada necessidade, é possível criar ambientes isolados de forma rápida, testar alterações, investigar problemas e acessar dados de pontos anteriores.
Para ambientes OLTP que precisam lidar com grandes volumes de dados e, ao mesmo tempo, manter agilidade no desenvolvimento, essa abordagem pode simplificar processos que tradicionalmente exigem cópias, dumps e longos períodos de atualização.
Mais do que uma funcionalidade de clonagem, o branching muda a forma de pensar os ambientes de banco de dados, aproximando o trabalho com dados de práticas já consolidadas no desenvolvimento de software.
