

escrito por Gleyson Jesus
10 minutos de leitura
Conceder acessos administrativos no banco de Produção para uma ferramenta externa expõe tabelas completas e dados sigilosos — como CPFs, senhas e informações de identificação pessoal (PII) — descumprindo normas rígidas de conformidade e as diretrizes da Lei Geral de Proteção de Dados (LGPD).
A partir do PostgreSQL 15, a Replicação Lógica nativa evoluiu com a introdução dos Filtros de Linha (Row Filters) e das Listas de Colunas (Column Lists). Esse recurso permite segmentar rigorosamente o que deve ser replicado, tornando-se uma solução elegante para isolar dados sensíveis antes que eles cheguem à nuvem.
Para viabilizar a ingestão sem comprometer o ambiente produtivo, a estratégia consiste em criar um cluster intermediário de Staging utilizando a Replicação Lógica nativa.
Diferente da replicação física — que realiza um espelhamento exato em nível de disco de todo o servidor — a replicação lógica opera em nível granular. O fluxo de dados funciona em três etapas:
Produção (Publisher): O cluster principal publica estritamente as colunas seguras e filtra apenas as linhas necessárias (ex.: clientes com cadastro ativo).
Staging (Subscriber): Um segundo cluster PostgreSQL atua como receptor executando em uma porta separada (ex.: 5433). Ele recebe exclusivamente os dados limpos e livres de PII.
Ingestão via AWS DMS: A ferramenta de CDC conecta-se com privilégios elevados apenas ao banco de Staging, que já se encontra devidamente higienizado.
Para demonstrar o funcionamento na prática, configuramos uma Prova de Conceito (PoC) utilizando um único servidor hospedando dois clusters PostgreSQL:
Cluster main (Publisher/ Produção): Executando na porta 5432.
Cluster staging (Subscriber/ Destino): Executando na porta 5433.
Abaixo, a captura de tela do terminal confirma a execução simultânea dos dois clusters no servidor:

1. Configuração do Servidor Primário (Publisher)
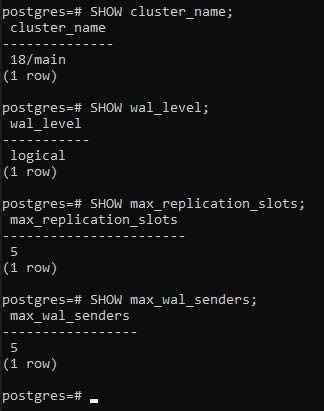
Acessando o cluster na porta 5432, o primeiro passo é validar se o parâmetro wal_level está definido como logical, garantindo também que os limites de slots de replicação (max_replication_slots) e enviadores (max_wal_senders) suportem a operação:
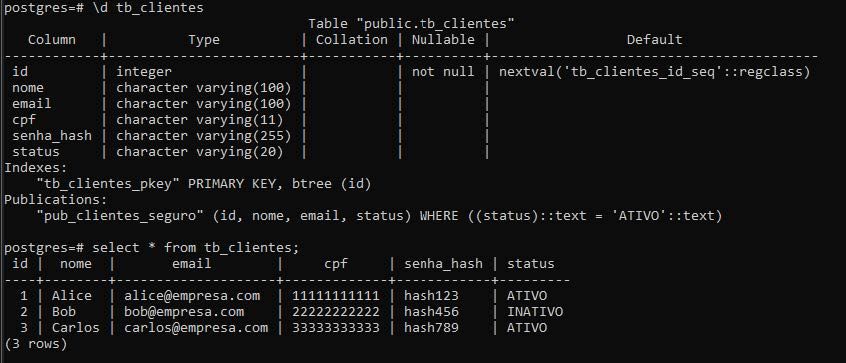
Em seguida, criamos a tabela tb_clientes no ambiente de Produção, contendo colunas com dados sensíveis (CPF e senha_hash) e registros com status ATIVO e INATIVO:
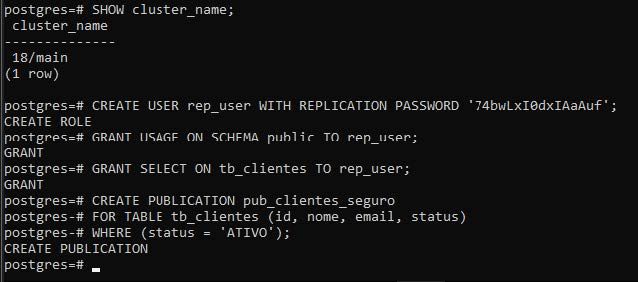
Com a tabela estruturada, criamos o usuário responsável pela replicação (rep_user), concedemos as permissões necessárias e aplicamos a regra de negócio na Publicação (pub_clientes_seguro). Definimos a Lista de Colunas (omitindo cpf e senha_hash) e o Filtro de Linha (WHERE status = 'ATIVO'):
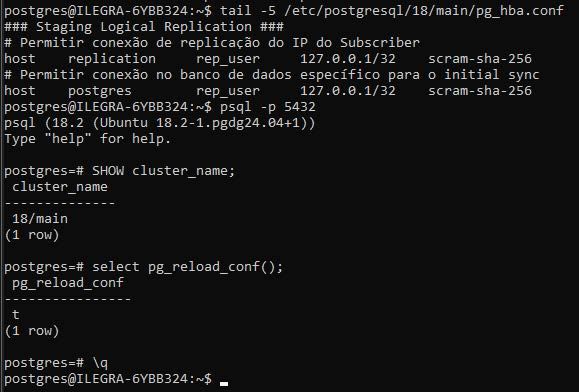
Por fim, liberamos o acesso de rede para o usuário de replicação no arquivo pg_hba.conf do cluster principal e executamos o recarregamento das configurações via pg_reload_conf():
Conectando-nos ao cluster de Staging (porta 5433), criamos a tabela tb_clientes omitindo as colunas sensíveis. Na sequência, configuramos a Assinatura (sub_clientes_staging) apontando para o cluster de Produção na porta 5432:
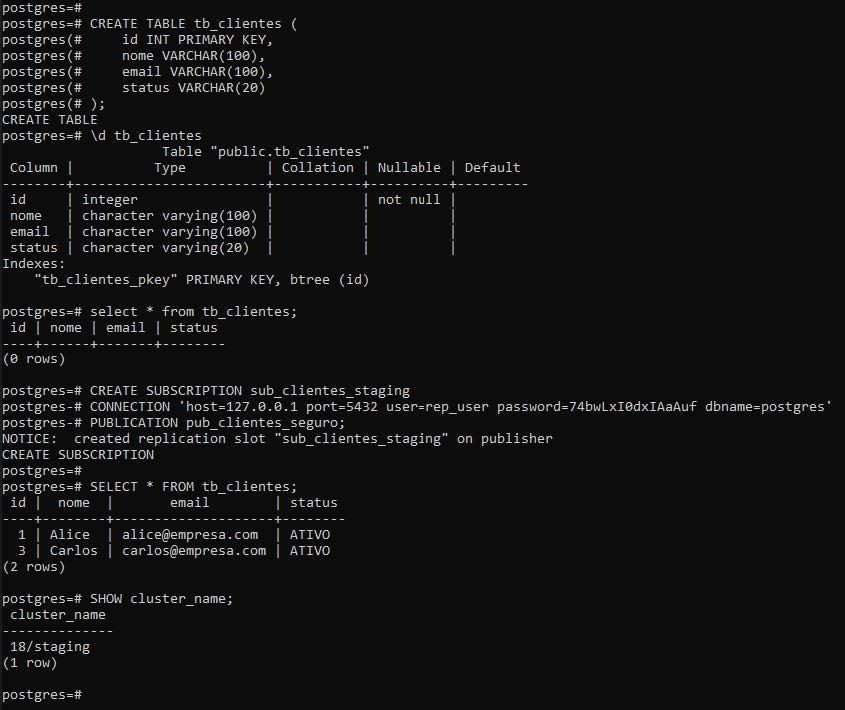
Resultado obtido no Staging:
Apenas os clientes Alice e Carlos foram replicados.
O cliente Bob (status INATIVO) foi descartado pelo filtro de linha.
As colunas cpf e senha_hash não existem no banco de destino.
Embora essa abordagem solucione os gargalos de conformidade e acesso, é fundamental considerar alguns fatores técnicos durante a implementação:
Isolamento de Recursos: Quando os clusters de Produção e Staging compartilham a mesma máquina física, consultas intensivas de leitura executadas pelo AWS DMS no Staging utilizarão CPU, memória e IO de disco da máquina. Para evitar impactos de performance na Produção, aloque o diretório de dados (data directory) do Staging em um disco físico separado.
Comportamento do DELETE com Filtros de Linha: Se o status de um registro for alterado em Produção de 'ATIVO' para 'INATIVO', o PostgreSQL interpreta que o dado deixou de cumprir o critério do filtro e enviará um comando de DELETE automático para o cluster de Staging. Os pipelines downstream no Data Lake devem estar preparados para esse comportamento.
Exigência do Replica Identity: Para que as operações de UPDATE e DELETE sejam replicadas corretamente utilizando listas de colunas, a Chave Primária (Primary Key) da tabela obrigatoriamente deve estar incluída na lista de colunas publicadas.
A introdução dos Row Filters e Column Lists no PostgreSQL transforma a Replicação Lógica em uma aliada estratégica para a governança de dados. Ao criar uma camada intermediária de Staging sanitizada, as equipes de engenharia de dados conseguem atender aos requisitos operacionais do AWS DMS e acelerar a integração com a nuvem, garantindo conformidade com a LGPD e eliminando a exposição desnecessária de informações confidenciais.
